Kafka를 써보고 싶다..!
요즘 채용공고를 보다 보면 Redis나 Kafka를 다뤄본 경험을 요구하는 곳이 자주 눈에 들어온다. 이름은 익숙한데, 내가 직접 써보고 왜 필요한지 설명할 수 있을까 싶었다. 회사 프로젝트에서 쓸 일이 생기기 전에 개인 프로젝트에 먼저 붙여보기로 했다.
마침 Rooma라는 웹 채팅 서비스를 만들고 있다. 호스트가 보낸 메시지는 방 전체에 보이고, 팬이 보낸 메시지는 호스트와 보낸 팬에게만 보이는 1:N 채팅이다. 실시간 메시지 전달에는 이미 Redis Pub/Sub을 쓰고 있었다.
서버 한 대에 회원 5만 명 이하를 가정하고 있어서 지금은 Redis Pub/Sub으로도 충분하다. 그래도 Kafka로 바꾸면 뭐가 달라지는지 직접 보고 싶었다. 특히 서버가 잠깐 꺼졌을 때 놓친 메시지를 다시 처리할 수 있다는 점이 궁금했다.
Kafka는 프로그램 사이에서 메시지를 주고받을 때 쓰는 시스템이다. 메시지를 일정 기간 저장해 두고, 읽는 쪽이 처리한 위치를 기록해서 멈췄다가도 이어서 읽을 수 있게 한다. 이번에는 이 차이를 내 코드에서 확인해봤다.
메시지 한 건이 처리되는 과정
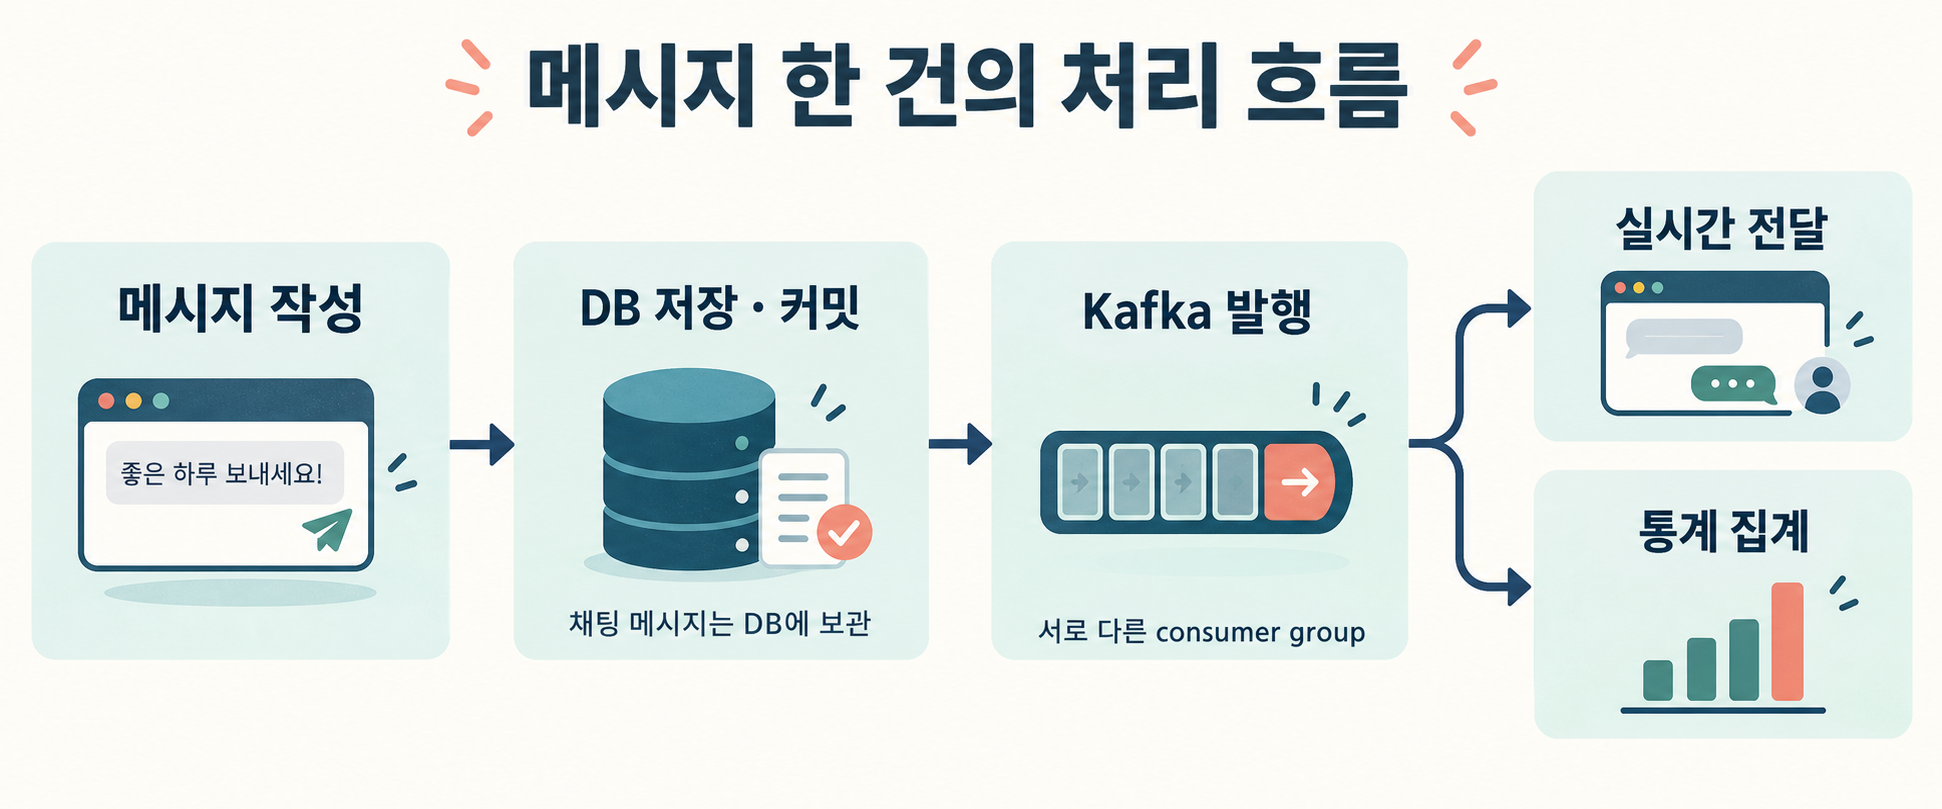
팬이 “안녕”이라고 보내면 서버에서는 대략 다음 순서로 처리한다.
- 메시지를 DB에 저장하고 커밋한다. 여기까지 끝나면 채팅 메시지 자체는 DB에 남는다.
- 커밋이 끝나면 브로커에 새 메시지가 생겼다고 알린다.
- 브로커를 구독한 서버 프로그램들이 메시지를 받아 각자 할 일을 한다.
Rooma에서 3번에 해당하는 프로그램은 두 개다. 하나는 접속 중인 브라우저로 메시지를 보내는 실시간 전달이고, 다른 하나는 채팅방별 메시지 수를 세는 통계다. Kafka에서 말하는 consumer는 이런 프로그램을 뜻한다.
사용자가 어디까지 읽었는지는 별개의 문제다. 그 정보는 DB에 저장하고 있었고 Kafka로 바꾸기 전에도 마찬가지였다. Kafka가 기억하는 것은 사용자의 읽음 위치가 아니라 각 프로그램이 어디까지 처리했는지다.
결과부터
차이가 실제로 보이는지 확인하려고 서버가 재시작되는 약 17초 동안 브로커에 메시지 10만 건을 넣었다. Redis와 Kafka에서 같은 방식으로 실행한 결과는 이랬다.
Redis Pub/Sub
[정상]       1,000건 발행 → 1,000건 전달
[재시작 중] 100,000건 발행 → 0건 전달, 복구 수단 없음
[복구 후]    1,000건 발행 → 1,000건 전달

Kafka
[정상]       1,000건 발행 → 바로 소비, lag 0
[재시작 중] 100,000건 발행 → lag 100,000
[재기동]     7.5초 뒤 lag 0
[복구 후]    1,000건 발행 → 바로 소비, lag 0
lag은 Kafka 로그의 끝과 해당 consumer group이 처리한 위치 사이의 거리다. 여기서는 아직 처리하지 않은 메시지 수라고 보면 된다.
브로커에 직접 메시지를 넣어서 확인한 결과다. 브라우저까지 도착하는지나 DB 커밋 후 발행 사이에 빠지는 메시지가 있는지는 이번에 확인하지 않았다.
Redis Pub/Sub과 Kafka에서 달랐던 점
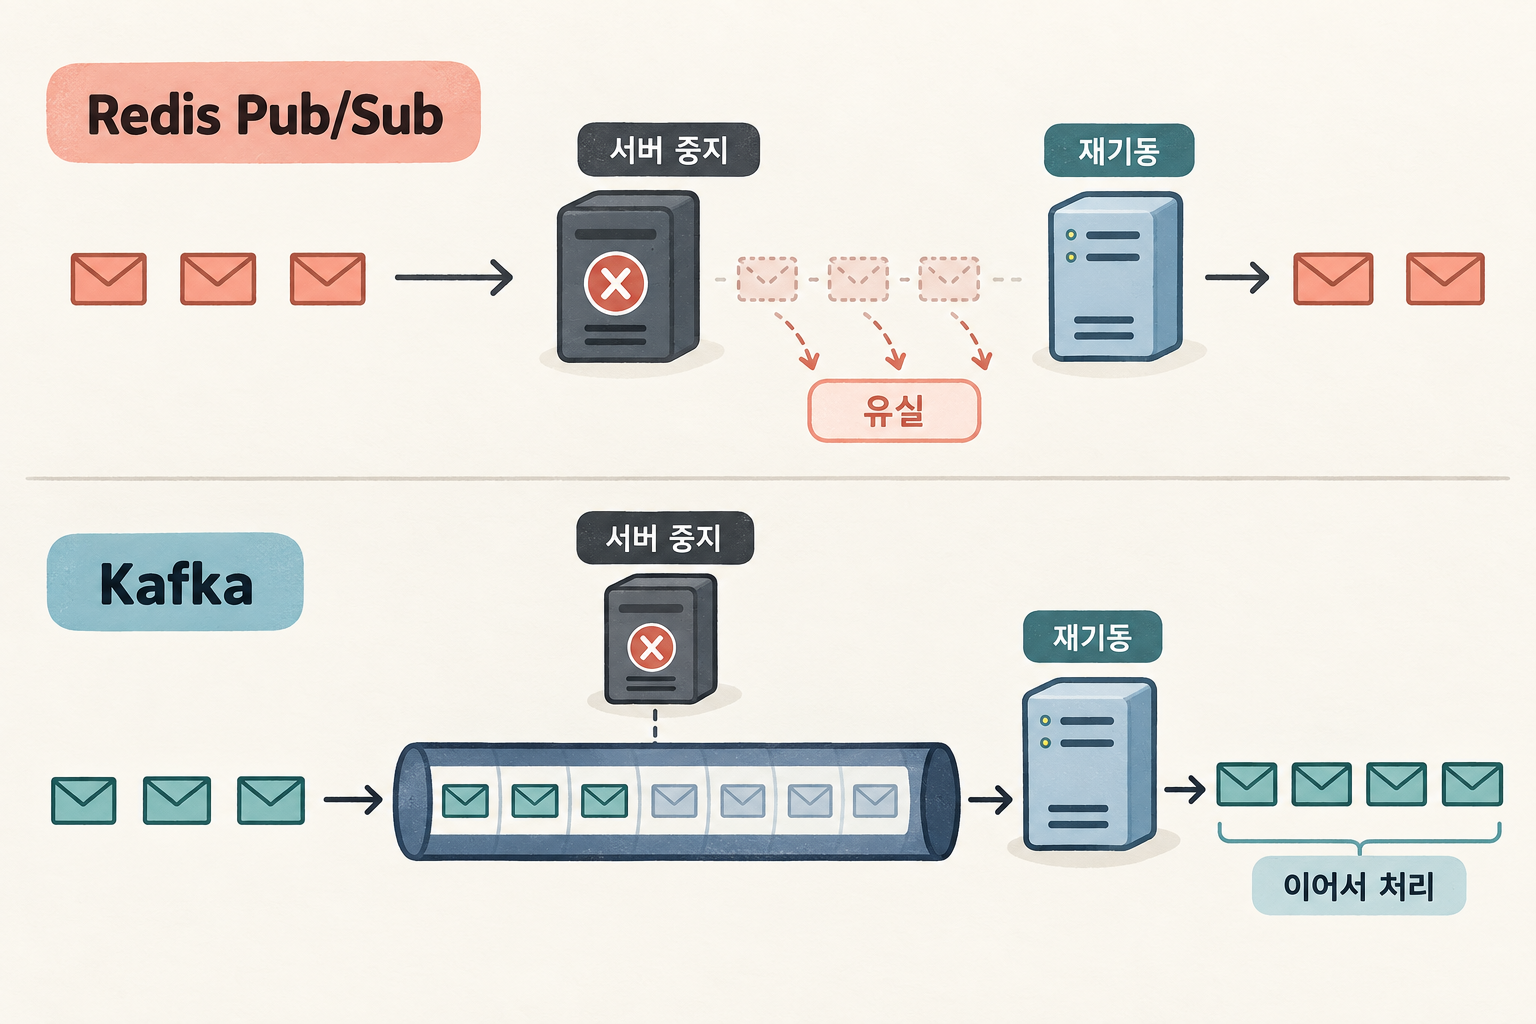
Redis Pub/Sub은 구독자가 실행 중일 때만 메시지를 받을 수 있다. 서버가 재시작하는 동안 발행된 메시지는 서버가 다시 살아나도 가져올 방법이 없다.
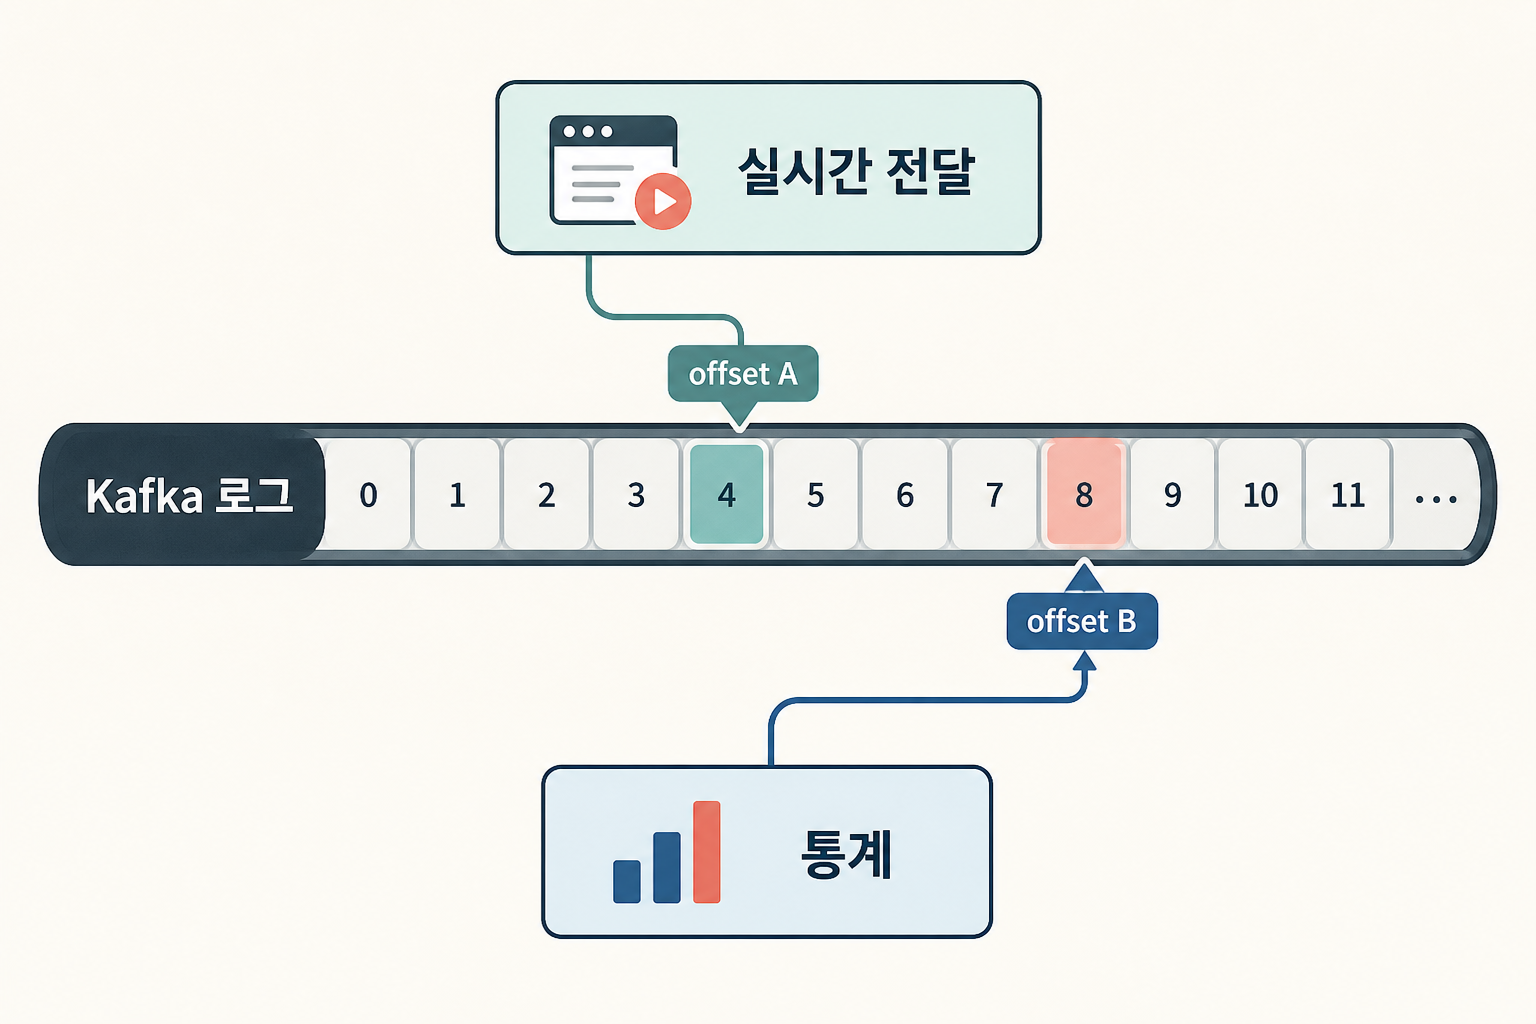
Kafka는 발행된 메시지를 로그에 남긴다. 각 consumer group은 마지막으로 처리한 위치(offset)를 따로 갖고 있어서, 잠시 멈췄다가 다시 실행되면 그 위치부터 이어서 읽을 수 있다.
Redis Pub/Sub이 라디오 생방송이라면 Kafka는 녹화 방송에 가깝다.
코드에서는 무엇이 바뀌었나
발행하는 쪽의 변화는 크지 않았다. DB 커밋 뒤 호출하는 코드를 바꿨다.
// 전: Redis
redisTemplate.convertAndSend("room:" + message.roomId(), json);

// 후: Kafka
kafkaTemplate.send("chat-message", message.roomId(), json); // topic, key=roomId, value
key로 방 ID를 사용했다. 같은 방의 메시지가 같은 파티션에 들어가도록 해서 방 안에서의 순서를 유지하기 위해서다. 전체 방 사이의 순서까지 맞출 필요는 없다.
읽는 쪽은 같은 토픽을 구독하되 서로 다른 consumer group을 사용한다.
// 실시간 전달
@KafkaListener(topics = "chat-message") // groupId는 설정 파일의 값을 사용
public void onMessage(ConsumerRecord<String, String> record) {
    // 호스트 메시지는 방 전체에 전달
    // 팬 메시지는 호스트와 작성 팬에게만 전달
}

// 통계
@KafkaListener(topics = "chat-message", groupId = "rooma-stats")
public void onMessage(ConsumerRecord<String, String> record) {
    // Redis에서 오늘 날짜와 방에 해당하는 메시지 수를 1 증가
}spring.kafka.consumer:
group-id: ${CHAT_CONSUMER_GROUP:rooma-chat-local} # 서버마다 다른 값
auto-offset-reset: latest # 새 그룹은 현재부터 소비여기서 한 번 헷갈렸다. Kafka에서는 같은 consumer group에 속한 프로그램끼리 메시지를 나눠 처리한다. Redis Pub/Sub처럼 모든 구독자에게 방송하려면 오히려 group 이름을 다르게 줘야 한다.
| 실시간 전달 | 통계 | |
|---|---|---|
| group 이름 | 서버마다 다르게 | 모든 서버가 같게 |
| 처리 방식 | 모든 서버가 모든 메시지를 받음 | 메시지마다 한 서버만 처리 |
| 이유 | 서버마다 연결된 브라우저가 다름 | 통계는 한 번만 세야 함 |
실시간 전달 서버를 같은 group으로 묶으면 메시지가 서버 한 대에만 간다. 그러면 다른 서버에 연결된 사용자는 메시지를 받지 못한다. 반대로 통계 consumer의 group을 서버마다 다르게 주면 서버 수만큼 중복 집계된다. 같은 동작이 한쪽엔 버그고 다른 쪽엔 설계다.
offset도 group마다 따로 관리된다. 메시지를 정상 처리하면 Spring이 해당 group의 처리 위치를 Kafka에 기록한다.
실시간 전달만으로는 Kafka가 필요하지 않았다
실시간 전달만 놓고 보면 Kafka의 장점이 크지 않았다. 서버가 재시작 중이면 브라우저 연결도 끊겨 있다. 서버가 살아나서 밀린 메시지를 읽어도 전달할 대상이 없고, 사용자는 재접속하면서 DB에서 지난 메시지를 받는다. Redis를 쓸 때도 이 흐름에는 문제가 없었다.
차이는 통계처럼 서버에서 빠짐없이 처리해야 하는 일이 붙으면서 생겼다. Redis Pub/Sub에서는 재시작 중 놓친 메시지가 통계에 반영되지 않는다. Kafka에서는 통계 consumer가 살아난 뒤 밀린 메시지를 이어서 처리한다.
두 consumer를 모두 멈춘 상태에서 10만 건을 발행하고, 다시 실행하면서 lag을 1초 간격으로 확인했다.
실시간 lag=100000  통계 lag=100000   ← 재기동 직전
실시간 lag=0       통계 lag=43424    ← 실시간 처리는 끝, 통계는 처리 중
실시간 lag=0       통계 lag=0        ← 1초 뒤 통계도 처리 완료
집계 결과: 100,000                   ← 브로커에 들어간 10만 건을 전부 셌다(이 실행에서는 유실·중복 0)
두 프로그램이 같은 메시지를 읽으면서도 서로 영향을 주지 않고 각자의 속도로 따라잡는 모습이 lag에 그대로 나타났다. 이번 전환에서 가장 확인하고 싶었던 부분이었다.
앞으로 부재중 푸시 알림이나 검색 색인처럼 메시지를 기준으로 동작하는 작업이 추가된다면 같은 방식으로 별도 group을 붙일 수 있다. 물론 지금 Rooma에 그런 기능이 필요한 것은 아니다.
도입 후…
지금 규모에서는 여전히 과설계라고 생각한다. 화면에 표시하지도 않는 통계를 위해 개인 NAS에 Kafka 컨테이너가 하나 더 돌고, 테스트도 무거워졌다. consumer는 같은 메시지를 두 번 받을 수 있으므로 중복 처리도 신경 써야 한다. 회사 프로젝트였다면 이 정도 요구사항으로 Kafka를 도입하자는 의견에는 나도 반대했을 것 같다…
그래도 해봐야지! 발행 지점을 처음부터 한 클래스에 모아 둔 덕분에 전환은 하루 안에 끝났고, 문제가 생기면 되돌릴 수 있게 Redis 버전 jar도 남겨 뒀다. 덕분에 consumer group과 offset이 단순한 용어가 아니라 실제 코드와 숫자로 연결됐다.
Redis도 그대로 사용하고 있다. 도배 제한과 로그인 시도 제한, 통계 결과 저장은 Redis가 맡는다. 현재 값을 빠르게 읽고 갱신하는 일과, 발생한 일을 순서대로 남겨 여러 프로그램이 각자 읽는 일은 성격이 달랐다. 직접 바꿔 보고 나니 둘 중 무엇이 더 좋다는 문제는 아니라는 것도 더 분명해졌다.
아직 남아 있는 문제들
- DB 커밋 후 Kafka 발행이 실패하면 통계에서 한 건이 빠진다. 아웃박스는 아직 적용하지 않았다.
- Kafka는 같은 메시지를 두 번 전달할 수 있다(at-least-once). 실시간 전달은 프론트에서
clientMessageId로 중복을 거르지만 통계는 아직 두 번 셀 수 있다. - 통계 consumer가 계속 실패하면 현재 설정에서는 10회 재시도 후 해당 메시지를 건너뛴다. Dead Letter Topic은 만들지 않았다.
- 서버 두 대를 띄운 재시작 실험은 아직 하지 않았다. 서버마다 group을 다르게 둔 실시간 전달 방식과, 백로그를 읽을 때 화면에 중복이 생기는지는 이 실험으로 더 확인해야 한다.
- TPS와 지연 시간은 측정하지 않았다. 이번에 확인하려던 것은 성능이 아니라 재시작 사이에 생긴 메시지를 다시 처리할 수 있는지였다.
결국 Rooma에 당장 Kafka가 필요하다는 결론은 아니었다. Redis Pub/Sub으로도 충분했던 이유를 알게 됐고, 어떤 요구사항이 생기면 Kafka가 필요할지 전보다 감이 잡혔다.